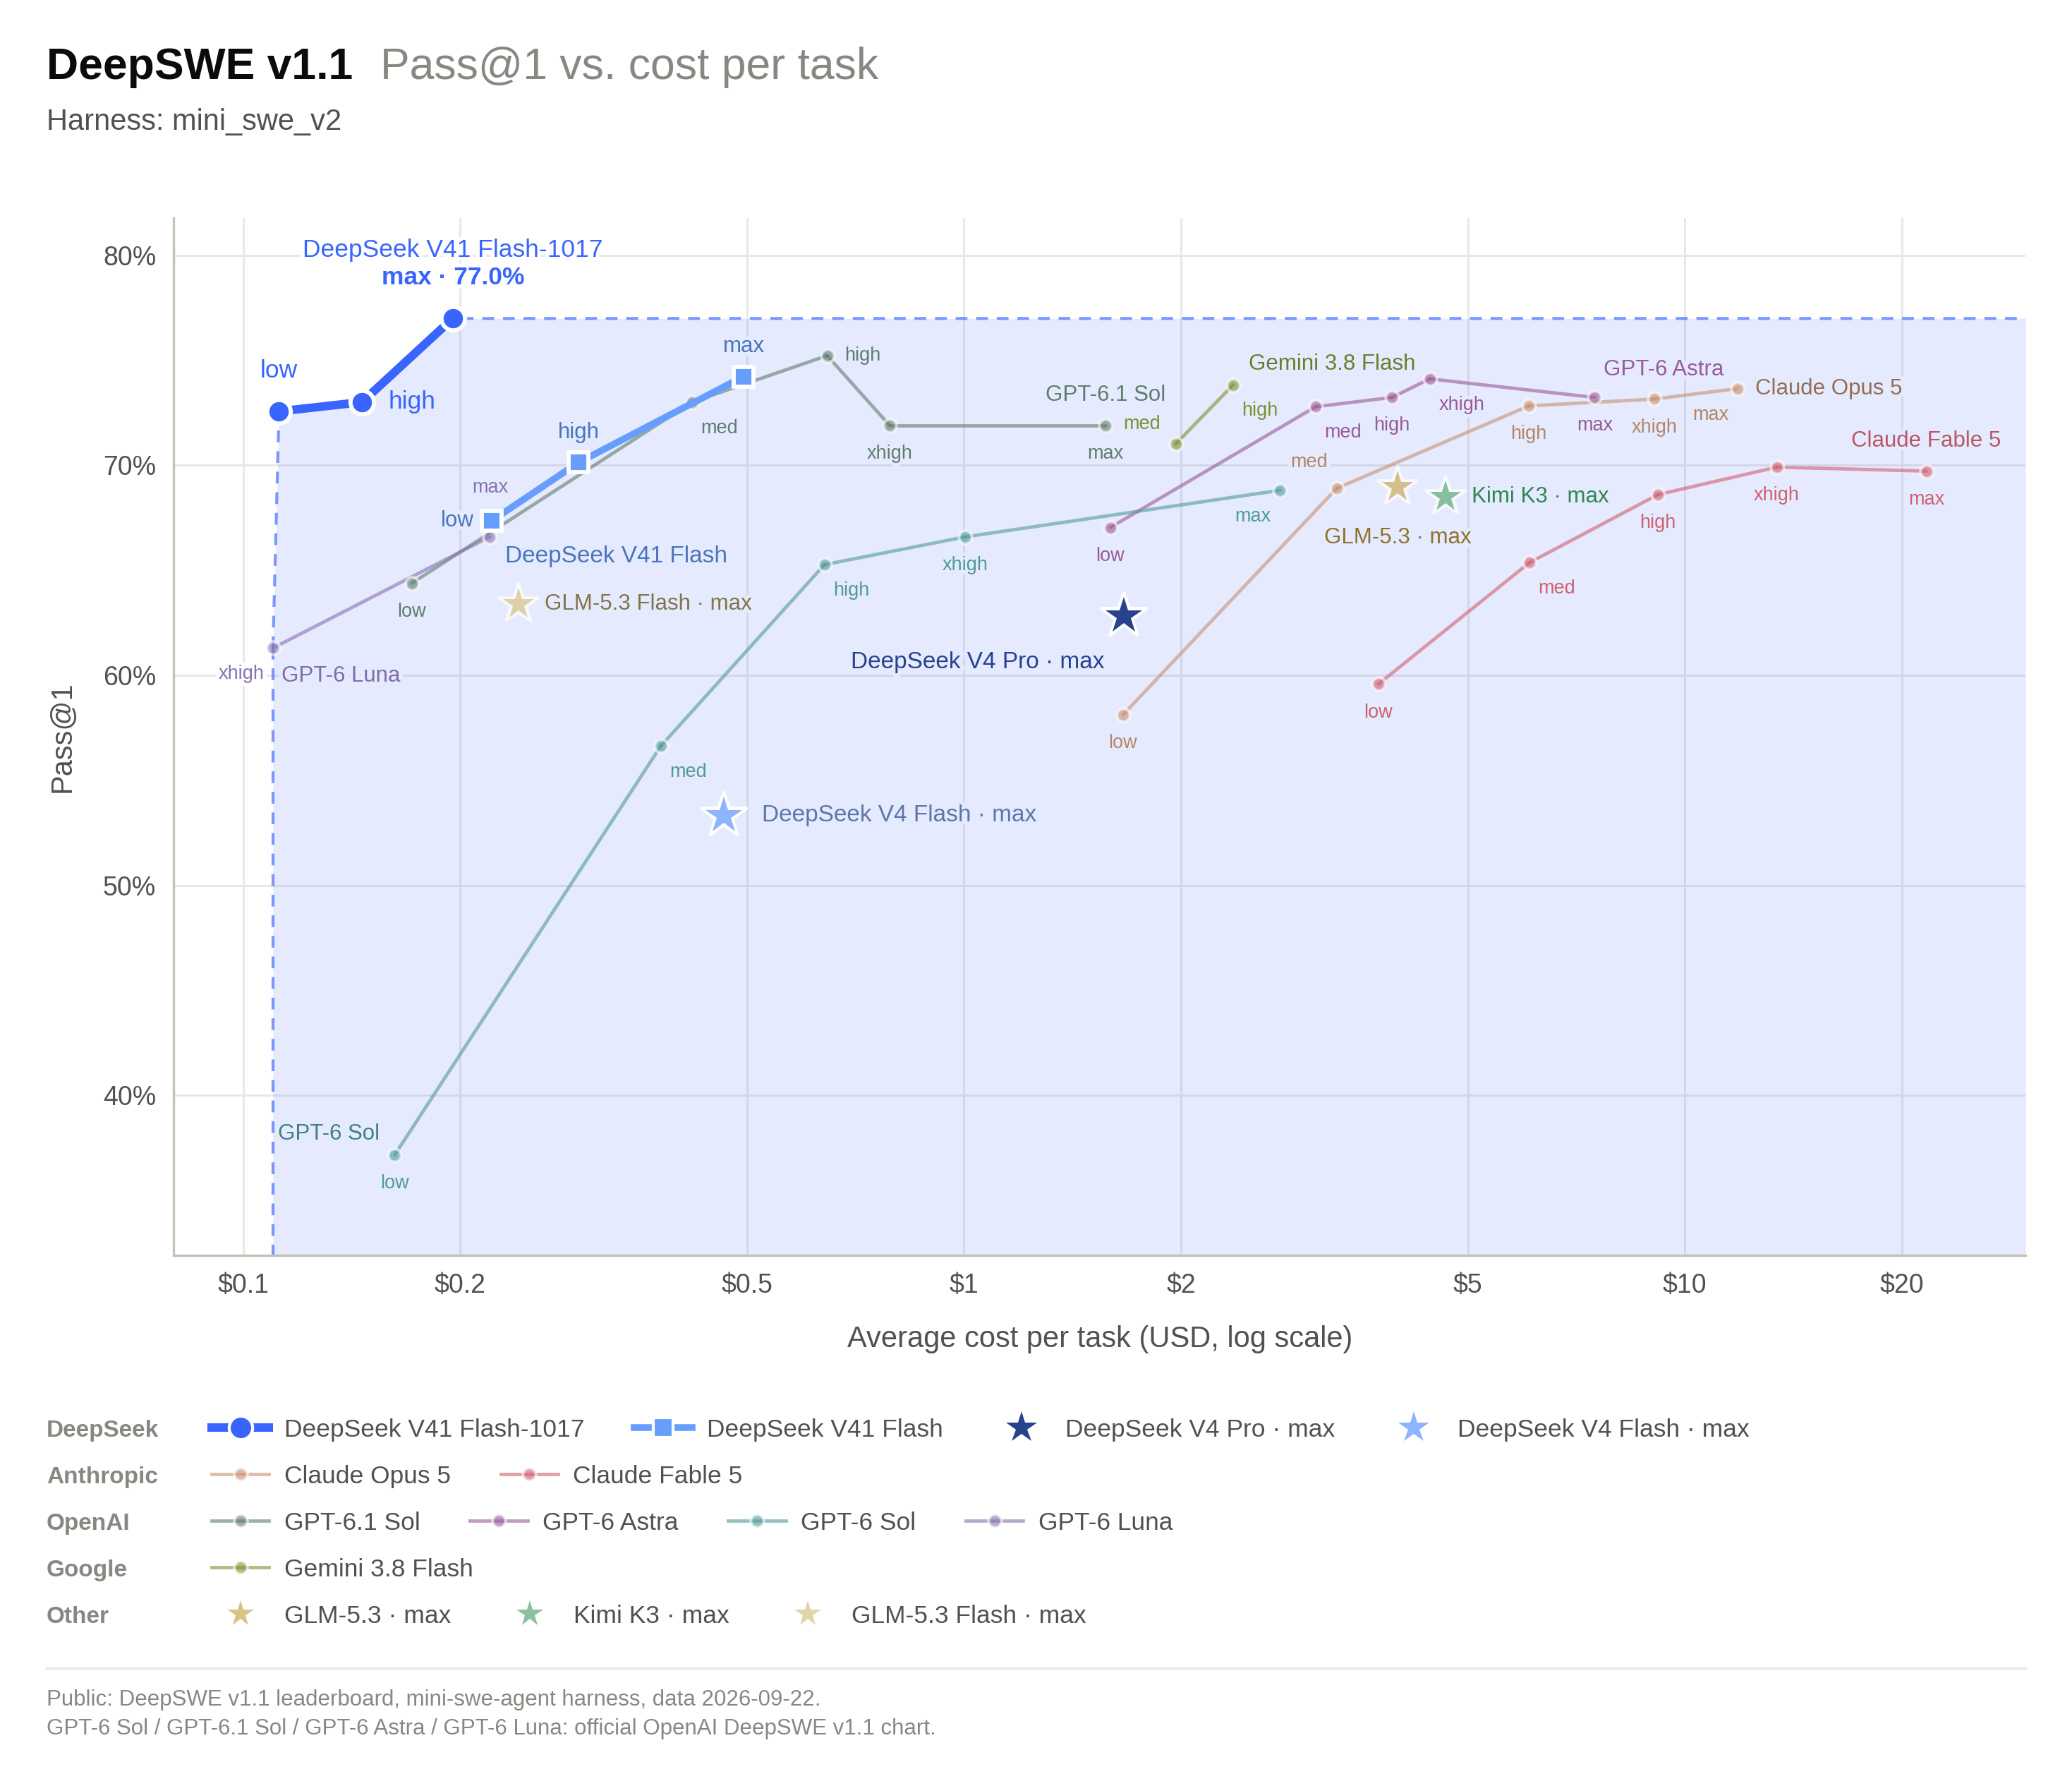
Le niveau de Claude Opus 5 pour une poignée de centimes ? DeepSeek-V4.1-Flash-1017 rend la question concrète. Publiée le 17 octobre 2026, cette mise à jour devance Opus 5 sur certains tests d’agents. Sur le graphique DeepSWE fourni par DeepSeek, son meilleur réglage atteint 77 % de réussite pour environ 0,20 dollar par tâche. Un résultat annoncé par le fabricant, sur un protocole précis.
La promesse mérite d’être regardée de près. Pour une équipe qui délègue des milliers de tâches à des agents de programmation, l’intérêt ne se limite pas à quelques points dans un classement : il tient au travail utile que chaque dollar permet d’obtenir.
DeepSeek-V4.1-Flash-1017 arrive sans hausse des prix
Le journal officiel de DeepSeek confirme la mise à jour du modèle sur le site, l’application et l’API. L’identifiant reste deepseek-flash et la méthode d’appel ne change pas. Les tarifs restent également identiques.
L’entreprise annonce des durées d’exécution et des sorties plus courtes, ainsi que des optimisations pour plusieurs environnements d’agents. Elle recommande DeepSeek Harness en version 0.2.1-rc.1 ou ultérieure.
Un harness est le logiciel qui entoure le modèle : il lui transmet les instructions, lui donne accès aux outils et organise ses actions. Cette couche compte dans la performance finale. Comparer deux noms de modèles sans regarder leur environnement d’exécution peut donc donner une lecture incomplète.
L’annonce de lancement met aussi en avant un apprentissage par renforcement avec retour sur ses propres productions, destiné à améliorer la réalisation de projets complets. Les jeux et scènes 3D montrés illustrent cette ambition ; des démonstrations choisies ne suffisent toutefois pas à établir une fiabilité générale.
Face à Claude Opus 5, des victoires ciblées
La fiche officielle du modèle présente le comparatif suivant. Les scores proviennent du tableau publié par DeepSeek ; ils ne résultent pas de tests reproduits pour cet article.
| Test | Flash précédent | Flash-1017 | Claude Opus 5 |
|---|---|---|---|
| DeepSWE v1.1 | 74,2 | 77,0 | 74,0 |
| Automation-Bench v1.0.6 | 54,8 | 60,5 | 50,3 |
| Agents’ Last Exam | 31,8 | 35,4 | 28,6 |
| Terminal-Bench 4.0 | 31,2 | 42,3 | 51,8 |
| ProgramBench | 20,3 | 29,1 | 37,0 |
| HLE sans outils | 36,8 | 42,6 | 56,3 |
Pour HLE, ces valeurs concernent l’ensemble complet, distinct du sous-ensemble uniquement textuel également mentionné par DeepSeek.
« Au niveau d’Opus 5 » demande de préciser la tâche
Le tableau soutient une lecture intéressante : Flash-1017 peut concurrencer, voire dépasser Opus 5 sur certains parcours d’agents. Il montre aussi des écarts nets en faveur d’Opus sur d’autres évaluations.
Le comparatif porte sur Claude Opus 5, pas sur toutes les versions de Claude. Il ne permet pas non plus de déduire une égalité de qualité pour la rédaction, l’analyse de documents ou un dépôt logiciel particulier. Choisir un modèle suppose de retrouver ses propres usages derrière les scores.
Ce que signifie vraiment « 0,20 dollar la tâche »
Le graphique performance-coût officiel situe le réglage maximal de Flash-1017 autour de 0,20 dollar de coût moyen par tâche sur DeepSWE v1.1, avec le harness mini-swe-v2. C’est un ordre de grandeur lu sur le graphique, et non un tarif forfaitaire proposé aux utilisateurs.
Le score affiché est un Pass@1 : une réussite mesurée lors d’une première tentative selon le protocole du test. Un coût moyen par tâche n’est donc pas un coût garanti par tâche réussie. Les essais ratés, les nouvelles tentatives et les corrections humaines comptent dans un usage réel.
Un calcul concret pour une requête API
La grille tarifaire de DeepSeek distingue heures creuses et heures pleines. Les prix ci-dessous sont en dollars américains par million de tokens.
| Type de tokens | Heures creuses | Heures pleines |
|---|---|---|
| Entrée, cache réutilisé | 0,003 $ | 0,006 $ |
| Entrée, hors cache | 0,15 $ | 0,30 $ |
| Sortie | 0,60 $ | 1,20 $ |
Exemple purement illustratif : 20 000 tokens d’entrée hors cache et 10 000 tokens de sortie facturés coûtent 0,009 dollar en heures creuses, soit 0,9 centime de dollar. En heures pleines, le total est de 0,018 dollar. Ce calcul ne reproduit pas une tâche du benchmark.
Un agent peut enchaîner de nombreux appels pour terminer un travail. Il faut additionner leur consommation, plutôt que confondre le prix d’une réponse et celui d’un projet. La grille applique les heures pleines de 01 h à 04 h et de 06 h à 10 h UTC, en semaine, hors jours fériés chinois ; le week-end est entièrement en heures creuses.
Des poids ouverts, mais un déploiement à préparer
Le fichier de licence officiel indique une licence MIT. Cela ouvre des possibilités d’utilisation et d’adaptation, avec conservation des mentions requises.
Le guide d’inférence présente néanmoins son code comme une implémentation de référence, pas comme un moteur de production. Il décrit notamment la conversion des poids et une exécution parallèle.
L’ouverture des poids donne ainsi une option supplémentaire pour l’hébergement et l’intégration. Elle ne dispense pas d’évaluer les ressources nécessaires, la maintenance et le débit réellement obtenu. Un tarif API bas ne prouve pas qu’héberger soi-même le modèle coûtera moins cher.
Le bon test : combien coûte un correctif accepté ?
Pour mesurer l’intérêt de Flash-1017, une équipe peut commencer par un lot de tickets représentatifs de son activité. Les mêmes tâches, les mêmes outils et les mêmes critères de validation permettent de comparer les résultats avec son modèle habituel.
Trois mesures seraient particulièrement utiles : le coût total des appels, la proportion de travaux acceptés et le temps de relecture. Une solution très économique devient moins convaincante si chaque proposition réclame une longue réparation. À l’inverse, un modèle suffisamment fiable sur les tâches courantes peut réserver le budget des modèles plus coûteux aux cas difficiles.
DeepSeek avance donc une proposition sérieuse sur le rapport performance-prix. Les chiffres publiés justifient de tester ce nouveau concurrent d’Opus 5. La décision se prendra ensuite au niveau du correctif accepté, avec les dépenses et le travail humain qui l’accompagnent.
Références
- DeepSeek — annonce de Flash-1017, 17 octobre 2026.
- DeepSeek — journal des changements, entrée du 17 octobre 2026.
- DeepSeek — fiche officielle et tableau des évaluations.
- DeepSeek — graphique DeepSWE v1.1, réussite et coût moyen par tâche.
- DeepSeek — tarifs API consultés le 17 octobre 2026.
- DeepSeek — licence MIT et guide d’inférence.